توسعه (Development)
هایلایتهای علی امیدیان
این فصل را خواندم و موارد زیر به نظرم برای برنامهریزی پروژه، استانداردهای توسعه و مدیریت تیم فنی مفید و کاربردی بود. هر نکته به بخش مرتبط در متن لینک شده است. برای کاملتر شدن مسیر مطالعه، فصل ۸؛ تصمیمهای فناوری و فصل ۱۰؛ مدیریت قرارداد نیز ادامه طبیعی این موضوع هستند.
- هرکدام از این حوزهها رشتهای مستقل است. لازم نیست بر همه آنها مسلط باشید، اما باید اهمیت و نقش هرکدام را در گروه خود بشناسید. از اطلاعرسانی درست درباره project planning، تا کسبوکار بتواند برای تحویل بهموقع محصول به شما و تیمتان تکیه کند، تا مدیریت حرفهای و پیشبینیپذیر releaseها، همهچیز باید نظاممند شود؛ یا به تعبیر ما، productionalized شود. 💡 CTO لازم نیست متخصص همه حوزهها باشد، اما باید نقش آنها را بشناسد و فرایندهای توسعه را نظاممند و قابل اتکا کند.
- متخصصان فناوری به رعایتنکردن deadline مشهورند؛ در عوض، در اعلام تاریخ و سپس ازدستدادن آن مهارت زیادی داریم! دلیلش خوشبینی همیشگی ماست: فکر میکنیم کارها به پیچیدگیای که به نظر میرسند نیستند. 💡 خوشبینی فنی را در تخمین زمان مهار کنید و پیچیدگیها و عوامل بیرونی را در برنامهریزی لحاظ کنید.
- وقتی گروه engineering از حدود پنج نفر بزرگتر میشود، داشتن project manager اختصاصی ضروری است. گروههای کوچکتر معمولاً میتوانند بین خودشان هماهنگی مؤثری ایجاد کنند. 💡 با عبور تیم مهندسی از حدود پنج نفر، مدیریت پروژه اختصاصی به حفظ هماهنگی و پیشبینیپذیری کمک میکند.
- Project manager با پیگیری و گزارش وضعیت افراد و منابع، پیشبینی و بهروزرسانی مداوم timelineها بر اساس اتفاقهای روزمره، به اجرای چشمانداز شما کمک میکند. برخلاف تصور رایج، وظیفه او دستور دادن و پاسخگو نگهداشتن افراد نیست؛ این مسئولیت leadهاست. اگر deadline در خطر باشد، باید سریع شما را از تأخیر احتمالی و دلیل آن باخبر کند تا، در صورت امکان، اقدام اصلاحی انجام دهید. 💡 مدیر پروژه با شفافکردن وضعیت و ریسک زمانبندی به اجرای چشمانداز کمک میکند؛ مدیریت عملکرد افراد مسئولیت لیدهاست.
- این افراد انگار استعداد سازماندهی را به ارث بردهاند؛ همراه با نگاهی واقعبینانه و روشی منظم. ما متخصصان فناوری گاهی خودمان را قانع میکنیم که روز بیشتر از ۲۴ ساعت دارد، اما آنها میدانند در یک روز کاری معمولی، با احتساب استراحت، ناهار، رفتوآمدهای کوتاه و حواسپرتی، شاید فقط شش ساعت کار مؤثر انجام شود. 💡 برنامهریزی واقعبینانه باید بر ظرفیت مؤثر روزانه تکیه کند، نه بر تمام ساعتهای اسمی روز کاری.
- Project management بیشتر هنر است تا علم: دیدن شرایطی که دائماً تغییر میکند، کنارزدن اطلاعات نامرتبط و اصلاح پیوسته مسیر برای رسیدن به هدف. 💡 مدیریت پروژه به مشاهده مداوم، تشخیص اطلاعات مرتبط و اصلاح مسیر در شرایط متغیر نیاز دارد.
- Project manager در این موارد کمک میکند: 💡 مدیر پروژه خروجی افراد، milestoneها، deadlineها، release cycleها، handoffها و گزارش وضعیت را هماهنگ و پیگیری میکند.
- Developerها و engineerها همیشه در بهروز نگهداشتن این کارهای پایه بهترین نیستند. Project manager در پیگیری updateهای ticket کمک میکند و اگر خوب عمل کند، مزایای آن را چنان نشان میدهد که به عادت تیم تبدیل شود. 💡 پیگیری منظم مدیر پروژه، بهروزرسانی ticketها را از کاری فراموششدنی به عادت مفید تیم تبدیل میکند.
- تعیین نتیجه، بخش آسان کار است. حالا باید راه رسیدن به آن را پیدا کنید و پروژه را به taskهای کوچکتری بشکنید که همگی در خدمت هدف نهایی باشند. در دنیای software، دو رویکرد اصلی برای این کار داریم: روش قدیمیتر Waterfall و رویکرد جدیدتر Agile. 💡 پس از تعریف نتیجه، پروژه را به کارهای کوچک و همراستا با هدف بشکنید و رویکرد اجرای مناسب را انتخاب کنید.
- هزینه این روش، زمان زیادی است که باید در ابتدا صرف تعریف پروژه کنید، بهخصوص برای پروژههای بزرگ؛ تا تعریف کامل نشود، کار شروع نمیشود. پروژهای را تصور کنید که قرار است در آن از میامی تا سانفرانسیسکو رانندگی کنید: تیم باید صبر کند تا کل مسیر مشخص شود. 💡 Waterfall پیش از شروع اجرا به تعریف کامل مسیر نیاز دارد و این طراحی اولیه میتواند آغاز پروژههای بزرگ را به تأخیر بیندازد.
- ضعف بزرگتر Waterfall، دشواری سازگارشدن با تغییر است. ممکن است فناوری یا requirementها دیگر مناسب نباشند، یا feature request تازهای مطرح شود. 💡 هزینه اصلی Waterfall در دشواری واکنش به تغییر نیازها، فناوری و درخواستهای تازه است.
- اگر Waterfall یعنی دانستن همهچیز پیش از شروع، سر دیگر طیف Agile است: مشخصکردن مسیر در حین حرکت. 💡 Agile مسیر را با یادگیری حین اجرا شکل میدهد، درحالیکه Waterfall میکوشد آن را پیشاپیش مشخص کند.
- در عمل، Agile مجموعهای از اصول و راهنماها برای continuous delivery نتایج است؛ با مشارکت همه ذینفعان، از جمله مشتری یا end user. چون مسئلهها زودتر دیده و اصلاح میشوند، کیفیت بالاتر میرود. 💡 تحویل پیوسته و مشارکت ذینفعان، بازخورد و اصلاح زودهنگام را ممکن میکند و کیفیت را بالا میبرد.
- برداشت اشتباه رایج این است که Agile یعنی نداشتن برنامه. پروژه Agile هم برنامهریزی میخواهد، فقط جزئیات آن از ابتدا به اندازه Waterfall نیست. Milestoneها، یا همان epicها در ادبیات Agile، شناسایی و به taskهای آماده اجرا تبدیل میشوند. 💡 Agile بیبرنامگی نیست؛ برنامه از epicها و taskهای اجرایی ساخته میشود، اما جزئیات آن بهتدریج تکامل مییابد.
- بعضی developerها فکر میکنند code آنها دستنزدنی است و review لازم ندارد. این افراد را زود شناسایی کنید؛ اگر نتوانستید این نگرش را تغییر دهید، همکاری را ادامه ندهید. 💡 پذیرش review و همکاری بر سر کیفیت code یک انتظار پایه است؛ مقاومت اصلاحناپذیر با کار تیمی سازگار نیست.
- Coding بیشتر هنر است تا علم و جای زیادی برای برداشتهای متفاوت دارد. چیزی که برای یک developer طبیعی است، ممکن است برای دیگری ناآشنا و نامأنوس باشد. Developerها گاهی عادت دارند هرچه را نمیفهمند rewrite کنند؛ همان افتادن از چاله به چاه. پس به نفع همه است که code با روشها و patternهای مشترک نوشته شود تا خواندن و فهمیدنش آسان باشد. 💡 روشها و patternهای مشترک، فهم code را برای دیگران آسان میکنند و از بازنویسیهای غیرضروری میکاهند.
- Code باید خوانا، قابل نگهداری و تا حد ممکن بدون خطا باشد. Standardها و code review به تحقق این هدف کمک میکنند. 💡 استانداردهای توسعه و بازبینی کد ابزارهای اصلی رسیدن به code خوانا، قابل نگهداری و کمخطا هستند.
- Quality assurance (QA) یا testing، خودش یک تخصص مستقل است. هدف آن ساده است: آیا چیزی که ساخته یا نصب کردهاید، همان کاری را انجام میدهد که انتظار دارید؟ 💡 QA تخصصی مستقل برای سنجش انطباق نتیجه واقعی محصول با رفتار مورد انتظار است.
- Testing آسان نیست؛ احتمالاً یکی از سختترین کارهای گروه شماست. پیشبینی تمام حالتها و actionهایی که یک software میتواند تجربه کند تقریباً ناممکن است. Test مثل پول است: هرقدر داشته باشید، باز هم کمی بیشتر به کارتان میآید. 💡 پوشش همه حالتها ناممکن است، اما افزایش سنجیده testها همواره اعتماد بیشتری ایجاد میکند.
- وقتی زمان پروژه کم میآید، توسعه testها معمولاً از اولین چیزهایی است که اولویتش پایین میرود. فرض کنید build بهدلیل fail شدن یک automated test متوقف شده است. خودتان را قانع میکنید که دلیلش business logic تازه است و نتیجه فقط یک false negative است. پس بهجای اصلاح test، آن را غیرفعال میکنید تا build تمام شود و به deadline برسید. 💡 فشار deadline نباید به غیرفعالکردن testهای ناموفق بدون بررسی و اصلاح علت آنها منجر شود.
- بهعنوان CTO مسئول maintainability بلندمدت سازمان هستید؛ یعنی باید بتوان در هر زمان، بدون حضور یک فرد خاص، code را با اطمینان build، update و deploy کرد. متأسفانه توان release بسیاری از سازمانهای کوچک به این وابسته است که یک نفر مشخص در مرخصی باشد یا نباشد. 💡 فرایندهای build، update و deploy را مستند و تکرارپذیر کنید تا release به حضور یک فرد وابسته نباشد.
- وقتی مرحلهای fail میشود، audit trail موجود در version control کمک میکند بفهمید مشکل با کدام تغییر و توسط چه کسی وارد شده است. هدف سرزنش نیست؛ هدف ساختن محیطی باز است که همه بتوانند کار یکدیگر را نقد کنند و برای software باکیفیتتر همکاری کنند. 💡 از audit trail برای یافتن منشأ مشکل و یادگیری جمعی استفاده کنید، نه برای سرزنش افراد.
- هر test بیشتر، هرچند کوچک، به اعتماد تیم هنگام release اضافه میکند و ریسک را کاهش میدهد. این مجموعه checkها پشتوانه ذهنیت «Release small; release often» است. 💡 مجموعهای از checkهای کوچک، ریسک releaseهای مکرر و کمحجم را کاهش میدهد.
- تصور کنید با خودرویی رانندگی میکنید اما هرگز روغن، فیلتر یا تایرهایش را عوض نمیکنید. در کوتاهمدت کمی پول ذخیره میکنید، اما با هربار عقبانداختن این کارها، مقداری «بدهی خودرو» ایجاد میشود. جایی این بدهی از ارزش خودرو بیشتر میشود؛ موتور از کار میافتد یا تایر در بزرگراه میترکد و هزینه بسیار بزرگتری تحمیل میکند. پس انجام بهموقع کارهای کوچک، از خرابیها و هزینههای بزرگ و غیرمنتظره ارزانتر است. 💡 رسیدگی مستمر به مشکلات کوچک، از انباشت بدهی و خرابیهای پرهزینه در آینده جلوگیری میکند.
- Technical debt در جریان کار یک سازمان پرشتاب بهطور طبیعی شکل میگیرد. برای پیشبردن کار پذیرفتنی است، به شرط اینکه مثل کارت اعتباری با آن برخورد کنید: میتوانید هزینه کوتاهمدت را روی کارت بگذارید، اما باید در پایان ماه آن را تسویه کنید. 💡 ایجاد آگاهانه technical debt میتواند موقتاً مفید باشد، به شرط آنکه برنامه مشخصی برای بازپرداختش وجود داشته باشد.
- قاعده تجربی من این است که ۱۰٪ تا ۳۰٪ خروجی تیم به کاهش این بدهی اختصاص پیدا کند. 💡 برای کاهش technical debt، ۱۰٪ تا ۳۰٪ ظرفیت خروجی تیم را بهصورت مستمر اختصاص دهید.
- به قول معروف، تا چیزی تحویل ندهید کاری نکردهاید. Release کردن code یا update یک enterprise platform زنده میتواند اتفاقی ساده و بیدردسر باشد، اما برای رسیدن به این سادگی باید تلاش زیادی پشت صحنه انجام شود. 💡 سادگی release نتیجه آمادگی، استانداردسازی و تلاش مستمر پشت صحنه است.
- پس از پایان release، یک postmortem برگزار کنید: موفقیتها را ببینید و از چیزهایی که بد پیش رفتند یا دفعه بعد میتوانند بهتر شوند یاد بگیرید. 💡 بعد از هر release، موفقیتها و فرصتهای بهبود را در یک postmortem مرور کنید.
- یکی از دشوارترین بخشهای هر release، تغییر database schema است. قاعده من برای حفظ امکان rollback این است: همیشه add کنید؛ فعلاً drop نکنید (always add, never drop). حذفکردن باعث میشود rollback بدون استفاده از backup ممکن نباشد. Table، column و index را میتوانید در releaseهای بعدی حذف کنید؛ وقتی از موفقیت release مطمئن شدهاید و دیگر نیازی به بازگشت به نسخه قبلی ندارید. 💡 برای حفظ rollback در تغییر schema، ابتدا ساختارهای تازه را اضافه کنید و حذف را به releaseهای بعد موکول کنید.
- مستقل از release strategy، تهیه release notes عادت خوبی است: documentی از همه تغییرات که میتواند یک text file، صفحه wiki یا صفحه Atlassian Confluence باشد. 💡 همه تغییرات هر release را در release notes ثبت کنید تا سابقهای روشن و قابل مراجعه داشته باشید.
- اما بدون کنترل، ممکن است تغییرهایی را تأیید کنید که فقط برای یک مشتری خاصاند، overhead غیرضروری ایجاد میکنند و در نهایت حرکت platform را کند میکنند. پاسخ هم نمیتواند همیشه «نه» باشد؛ مانعتراشی دائمی رابطه شما را با کسبوکار و مشتری بهتر نمیکند. در عوض، هر feature request را طوری بررسی کنید که انگار قرار است برای همه مشتریان ارائه شود: 💡 درخواست هر مشتری را با نگاه به ارزش عمومی آن برای platform ارزیابی کنید تا از پیچیدگی اختصاصی و overhead بلندمدت جلوگیری شود.
این فصل پوشش میدهد (This chapter covers)
- مدیریت پروژهها و اطلاعرسانی درباره پیشرفت، چه خوب و چه بد، به کسبوکار
- تکامل development practiceها متناسب با رشد تیم
- مدیریت کیفیت و testing برای رسیدن به releaseهای موفق
- پرهیز از solutionهایی که به client lock-in منجر میشوند
بسیاری از CTOها از پیشینه engineering میآیند و سالها درگیر ساختن و نوشتن code بودهاند. آنها در مسیر development رشد کردهاند و بهتدریج پروژههای بزرگتر و مسئولیت بیشتری گرفتهاند. هر developer روش خودش را برای انجام کارها دارد و دوست دارد ردپای خودش را در کار بگذارد. همین است که زندگی در development را جذاب میکند: آزادی خلاقانه برای انجام آنچه لازم است. اما وقتی نوبت ساختن تیم یا رشد دادن سازمان میرسد، باید از آن دنیای فردی فاصله گرفت و گستردهتر و جمعیتر فکر کرد. چیزی که روزی هوشمندانه و جذاب به نظر میرسید، ممکن است برای نفر بعدی دردسری برای maintenance و تغییر باشد.
این فصل بر حوزههایی تمرکز دارد که یک CTO در حال گذار از نقش developer به مدیر اجرایی باید هرچه زودتر و بهطور جدی در نظر بگیرد؛ چون همینها پایههای موفقیت آینده را میسازند. مانند بسیاری از موضوعهای این کتاب، هرکدام از این حوزهها رشتهای مستقل است. لازم نیست بر همه آنها مسلط باشید، اما باید اهمیت و نقش هرکدام را در گروه خود بشناسید. از اطلاعرسانی درست درباره project planning، تا کسبوکار بتواند برای تحویل بهموقع محصول به شما و تیمتان تکیه کند، تا مدیریت حرفهای و پیشبینیپذیر releaseها، همهچیز باید نظاممند شود؛ یا به تعبیر ما، productionalized شود.
کارهای سادهای مثل تعیین coding standardهای مشترک، code را خواناتر و در نتیجه نگهداری آن را آسانتر میکنند. گامهای کوچک میتوانند اثر بزرگی داشته باشند. همچنین ضرورت ساختن یک build process تکرارپذیر را بررسی میکنیم تا کسبوکار بتواند روی ارائه updateها حساب کند، بدون اینکه هر بار با کابوسی از هماهنگی و اجرا روبهرو شود.
موضوع این فصل ساختن یک development process حرفهای، تکرارپذیر و قابل اتکاست؛ فرایندی که افراد تازهوارد در آن طی چند ساعت یا چند روز به کار مؤثر برسند، بهجای اینکه هفتهها با جزئیات عجیب یک coding process قدیمی دستوپنجه نرم کنند.
از دل تجربه: محیط توسعهای که تولید را اجرا میکرد (From the field: Development environment running production)
یک website خوشساخت و آراسته میتواند دنیایی از آشفتگی، وصلهپینه و میانبر را پنهان کند. در یکی از due diligenceهایی که در آن مشارکت داشتم، دوباره دیدم نگرفتن چند تصمیم ساده در ابتدای کار میتواند در آینده میلیونها دلار هزینه داشته باشد. این شرکت SaaS محصول بسیار خوبی داشت، اما CTO نه استانداردی تعیین کرده بود و نه release policy رسمیای را اجرا میکرد. حاصل، مجموعهای بیضابطه از code و library بود که security قابلاعتنایی هم نداشت. کل release process به یک نفر، یعنی CTO، وابسته بود.
این CTO با productionalize نکردن خروجی تیم، چنان technical debt بزرگی ایجاد کرده بود که در نهایت ارزش شرکت را پایین آوردند تا هزینه اصلاحات در قیمت لحاظ شود. او دانش لازم برای رشد دادن تیم فراتر از مهارتهای شخصیاش در development را نداشت.
۹.۱ برنامهریزی پروژه (Project planning)
یکی از سختترین وظایف شما بهعنوان CTO، توضیح timelineها به کسبوکار است. چه موضوع یک پروژه یا اقدام بزرگ باشد و چه یک task کوچک، دیگران باید بدانند تیم چه زمانی ظرفیت دارد و چه وقت کار را تحویل میدهد تا بتوانند کارهای وابسته به آن را پیش ببرند. متخصصان فناوری به رعایتنکردن deadline مشهورند؛ در عوض، در اعلام تاریخ و سپس ازدستدادن آن مهارت زیادی داریم! دلیلش خوشبینی همیشگی ماست: فکر میکنیم کارها به پیچیدگیای که به نظر میرسند نیستند. اغلب هم درباره خود کار درست فکر میکنیم، اما نیروهای بیرونیای را حساب نمیکنیم که برنامه را بههم میزنند؛ مثلاً همان مشتریانی که وسط یک deadline کاملاً دستیافتنی سر میرسند!
با رخدادهای بیرونی، کشفهای تازه و scope creep، پیشبینی گاهی ناممکن به نظر میرسد. اما لازم نیست چنین باشد. کمی برنامهریزی دقیق و تعدیل خوشبینی در اطلاعرسانی به کسبوکار میتواند حتی سختگیرترین CEO را هم همراه کند تا شما و تیمتان کار را ادامه دهید.
۹.۱.۱ مدیر پروژه (Project manager)
دو نوع سازمان وجود دارد: آنهایی که project manager خوبی دارند و آنهایی که ندارند. دلیل نداشتن project manager اختصاصی ممکن است نبود بودجه باشد، که قابلدرک است، یا این باور که CTO خودش project management بلد است و نیازی به این نقش نیست، که دلیل موجهی نیست. به نظر من، وقتی گروه engineering از حدود پنج نفر بزرگتر میشود، داشتن project manager اختصاصی ضروری است. گروههای کوچکتر معمولاً میتوانند بین خودشان هماهنگی مؤثری ایجاد کنند.
برای این بحث، فرض کنیم Scrum master و project manager هدفهای مشابهی دارند. هرچند تفاوتهای ظریفی میان این دو نقش هست، روح کارشان بسیار نزدیک است. Project manager با پیگیری و گزارش وضعیت افراد و منابع، پیشبینی و بهروزرسانی مداوم timelineها بر اساس اتفاقهای روزمره، به اجرای چشمانداز شما کمک میکند. برخلاف تصور رایج، وظیفه او دستور دادن و پاسخگو نگهداشتن افراد نیست؛ این مسئولیت leadهاست. اگر deadline در خطر باشد، باید سریع شما را از تأخیر احتمالی و دلیل آن باخبر کند تا، در صورت امکان، اقدام اصلاحی انجام دهید.
Project manager جلسههای دورهای را اداره میکند و ticketing system را زیر نظر دارد تا تقریباً در لحظه از خروجی گروه باخبر باشد. افراد خوب در این نقش، جریان آزاد اطلاعات را تشویق میکنند؛ چه خبر خوب باشد و چه بد. بدون این جریان، نمیتوان timeline را درست مدیریت کرد.
این افراد انگار استعداد سازماندهی را به ارث بردهاند؛ همراه با نگاهی واقعبینانه و روشی منظم. ما متخصصان فناوری گاهی خودمان را قانع میکنیم که روز بیشتر از ۲۴ ساعت دارد، اما آنها میدانند در یک روز کاری معمولی، با احتساب استراحت، ناهار، رفتوآمدهای کوتاه و حواسپرتی، شاید فقط شش ساعت کار مؤثر انجام شود. میدانند کسی که از مرخصی برمیگردد برای بازگشت به ریتم کار زمان لازم دارد؛ درحالیکه ما انتظار داریم بعد از دو هفته استراحت کنار ساحل، از همان لحظه ورود کاملاً آماده کار باشیم.
Project management بیشتر هنر است تا علم: دیدن شرایطی که دائماً تغییر میکند، کنارزدن اطلاعات نامرتبط و اصلاح پیوسته مسیر برای رسیدن به هدف. اگر با drone پرواز کرده باشید، احتمالاً از software آن شگفتزده شدهاید؛ وقتی باد مسیرش را تغییر میدهد، با تنظیم لحظهای ملخها موقعیت خود را حفظ میکند و همهچیز را ساده نشان میدهد. Project manager هم ورودیها را تحلیل میکند، نتیجه ادامه مسیر فعلی را پیشبینی میکند و این اطلاعات را به شما برمیگرداند تا اقدام اصلاحی انجام دهید.
Project manager در این موارد کمک میکند:
- شناخت و پیگیری خروجی هر فرد یا منبع
- شناسایی milestoneها و deliverableها
- پیشبینی deadlineها و بهبود مداوم دقت آنها
- هماهنگی release cycleها
- مدیریت handoff بین milestoneها و ارتباط با تیمهای داخلی و بیرونی
- ارائه اقدامهای مشخص بر پایه data برای بهبود مدیریت زمان شما
- گزارش وضعیت همه موارد و اطمینان از اینکه چیزی فراموش یا از پیگیری خارج نمیشود
در سازمانی که کار کافی برای project manager تماموقت ندارد، رایج است که همین فرد نقش business analyst را هم بر عهده بگیرد و جزئیات پروژه را از دید کسبوکار تعریف کند. Project managerها معمولاً برای هماهنگکردن منطقی milestoneها، بههرحال تا حدی وارد این جزئیات میشوند.
ریتم ارتباطی ثابت با project manager، مثلاً گفتوگوی روزانه، بسیار مهم است. او باید بتواند خبر بد را بدون نگرانی از واکنش غیرحرفهای یا سرزنش شما منتقل کند. کارهای لازم را یادآوری میکند و در برنامه جا میدهد؛ مثلاً maintenance سالانهای که برای انجام upgradeها مدتی بخشی از تیم را از کارهای دیگر دور میکند. پیشبینی این رویدادها به تیم اجازه میدهد منظم کار کند، بهجای اینکه همیشه در واکنش به اتفاقها باشد. این دید به شما کمک میکند انتظارها را با دقت بیشتری به CEO و board منتقل کنید.
سیستم تیکت (Ticket system)
برای اداره گروهی با هر اندازه، باید بدانید هر نفر اکنون روی چه چیزی کار میکند و چه کارهایی در برنامه اوست. متخصصان فناوری معمولاً از تمامکردن کارها لذت میبرند: هم فهرست taskها را دوست داریم و هم رضایت علامتزدن یک کار تمامشده را. همین ترکیب توضیح میدهد چرا ticket systemها از ابزارهای اصلی مدیریت task در فناوری هستند. Atlassian Jira نمونه شاخصی است که امکانات ticket را بسیار گسترش داده است.
جایگزینهای زیادی وجود دارند، اما اصل مشترکشان یکی است: ticket واحدی از کار با یک شناسه یکتاست که در زمانی مشخص به فردی مشخص واگذار میشود. Ticket چرخه عمر دارد؛ از وضعیت open شروع میشود و به closed میرسد، با وضعیتهای مختلف در میان این دو. Closed میتواند به معنی تکمیل کار یا کنارگذاشتن آگاهانه آن بهدلیل نامرتبطبودن باشد. Open یعنی هنوز باید بررسی و اقدامی انجام شود.
Ticketها را میتوان در epic، story یا project گروهبندی کرد و برایشان subticket ساخت. کمی بعد درباره Agile صحبت میکنیم. معنایی که به ticket میدهید انتخاب شماست، اما باید برای کل تیم روشن باشد.
میتوانید ticket را واحدی از کار تعریف کنید که بیشتر از یک بازه مشخص، مثلاً چهار ساعت، طول نکشد. اگر طولانیتر است، آن را به چند ticket کوچکتر تقسیم کنید. این روش جلوی اتلاف تلاش را هم میگیرد: اگر فرد در نیمه بازه متوجه شود به پایان کار نمیرسد، فرصت دارد متوقف شود و کمک بخواهد. شاید کار را بیش از حد پیچیده کرده یا فردی که task را تعریف کرده پیچیدگی آن را درست نفهمیده است؛ در این صورت باید کار را باز هم کوچکتر کرد.
بهتر است تکمیل یک ticket روزها یا هفتهها طول نکشد، چون project management را سختتر میکند. اندازهای انتخاب کنید که برای سازمان شما مناسب باشد و آن را به همه توضیح دهید. عادتدادن تیم به مدیریت ticketهای خود، مرور اولویتها و برنامهریزی روزانه در بلندمدت سود میدهد: حجم کار روشن میشود و افراد استقلال بیشتری برای مدیریت کارهای خود پیدا میکنند.
مزیت مهم دیگر ticket system مرکزی، زبان مشترکی است که برای صحبت درباره taskها میسازد. شنیدن اینکه اعضای تیم هنگام بحث درباره کار یا درخواست کمک، شماره ticketها را به هم میگویند برای من لذتبخش است. هرکس میتواند با آن شماره، پیشینه کار، commentها و code مرتبط را ببیند و با شناخت بیشتری مشارکت کند.
Ticket system خوب میتواند یک knowledge base زنده هم باشد، بهویژه اگر برای client support استفاده شود. شرطش این است که فرد هنگام بستن ticket، مراحل حل مسئله را با جزئیات کافی ثبت کند تا دیگران بتوانند از آن یاد بگیرند.
Developerها و engineerها همیشه در بهروز نگهداشتن این کارهای پایه بهترین نیستند. Project manager در پیگیری updateهای ticket کمک میکند و اگر خوب عمل کند، مزایای آن را چنان نشان میدهد که به عادت تیم تبدیل شود. بخش بزرگی از گزارشها و اقدامهای او از همین سیستم میآید، پس بهروز بودن آن برای خودش هم مهم است. جلوتر میبینیم که ticket system چگونه به برنامه release پروژهها کمک میکند.
۹.۱.۲ تعریف پروژهها (Defining projects)
در سطح کلی، پروژه مجموعهای از taskهاست که تکمیل آنها به نتیجهای مطلوب میرسد. بحث از جایی شروع میشود که بخواهیم scope آن را تعیین کنیم: یک task باید چقدر بزرگ باشد تا پروژه محسوب شود؟ پروژه ممکن است چند روز یا چند سال طول بکشد. مستقل از مدت، باید هدف روشنی داشته باشد؛ همان دلیلی که پروژه برای آن ایجاد شده است. هدف قرار نیست روش انجام کار یا زمان لازم را توضیح دهد، بلکه success criteria را مشخص میکند؛ معیارهایی که با تحققشان پروژه کامل محسوب میشود.
نتیجه پروژه را طوری بنویسید که افراد بیرون از گروه engineering هم آن را بفهمند. این کار شفافیت و ارتباط را بهتر میکند، بهخصوص برای CEO و CFO که میخواهند بدانند شما و تیمتان زمان و پول را کجا صرف میکنید. این دو تعریف، به یک پروژه اشاره دارند:
- برای داخل تیم (Internal): upgrade کردن فرایند پذیرش مشتری، حذف وابستگی به Windows XP و rewrite آن با Java در یک serverless environment.
- برای بیرون تیم (External): نوسازی فرایند پذیرش مشتری و rewrite آن برای Cloud، با هدف انعطاف بیشتر و throughput بالاتر.
تعیین نتیجه، بخش آسان کار است. حالا باید راه رسیدن به آن را پیدا کنید و پروژه را به taskهای کوچکتری بشکنید که همگی در خدمت هدف نهایی باشند. در دنیای software، دو رویکرد اصلی برای این کار داریم: روش قدیمیتر Waterfall و رویکرد جدیدتر Agile.
مدل آبشاری (Waterfall)
در Waterfall تا جای ممکن پیش از شروع کار برنامهریزی میکنید. ایده شبیه آبشاری است که جریان از بالای آن آغاز میشود و به پایین میرود. تأکید زیادی بر تحلیل problem domain وجود دارد تا مسئلهها و مشکلات لازم برای حل شناسایی شوند. بسیاری از تصمیمهای design و ساختار هم در همین مرحله گرفته میشوند. هدف این است که پیش از اختصاص منابع، تا حد ممکن درباره پروژه بدانید.
برنامهریزی اولیه ممکن است طولانی باشد، اما برای پروژهای که خوب تعریف شده، پیشبینی زمان و هزینه آسانتر میشود. چنین پروژهای برای گرفتن پیشنهاد از شرکتهای بیرونی هم آمادهتر است.
هزینه این روش، زمان زیادی است که باید در ابتدا صرف تعریف پروژه کنید، بهخصوص برای پروژههای بزرگ؛ تا تعریف کامل نشود، کار شروع نمیشود. پروژهای را تصور کنید که قرار است در آن از میامی تا سانفرانسیسکو رانندگی کنید: تیم باید صبر کند تا کل مسیر مشخص شود.
ضعف بزرگتر Waterfall، دشواری سازگارشدن با تغییر است. ممکن است فناوری یا requirementها دیگر مناسب نباشند، یا feature request تازهای مطرح شود. بعضی پروژههای بزرگ چون پذیرش تغییر دشوار است، آن را نادیده میگیرند و به مسیر قبلی ادامه میدهند. در نتیجه، گاهی محصولی با فناوری قدیمی تحویل داده میشود که دیگر هدف اولیه را برآورده نمیکند. من این وضعیت را بیشتر در پروژههای دولتی یا شرکتهای عمومی دیدهام؛ جایی که تغییر به موافقت افراد زیادی نیاز دارد و اختلال زیادی ایجاد میکند.
پروژههای Waterfall در ابتدا documentation بیشتری تولید میکنند، از جمله wireframe و mockup. این کار معمولاً با همکاری subject matter expertها، business analystها، architectها و project managerها انجام میشود.
رویکرد چابک (Agile)
اگر Waterfall یعنی دانستن همهچیز پیش از شروع، سر دیگر طیف Agile است: مشخصکردن مسیر در حین حرکت. این توصیف کمی شوخیآمیز است؛ منظور این است که لازم نیست همه مسئلهها پیش از شروع کاملاً شناخته یا حل شده باشند. Agile بر واکنش به محیط متغیر و برداشتن گامهای تدریجی برای نزدیکشدن به نتیجه نهایی تکیه دارد.
در مثال سفر به سانفرانسیسکو، بهمحض اینکه راه خروج از فلوریدا را بدانیم، تیم میتواند تا مرز ایالت حرکت کند و همزمان مرحلههای بعد برنامهریزی شوند. در عمل، Agile مجموعهای از اصول و راهنماها برای continuous delivery نتایج است؛ با مشارکت همه ذینفعان، از جمله مشتری یا end user. چون مسئلهها زودتر دیده و اصلاح میشوند، کیفیت بالاتر میرود.
برداشت اشتباه رایج این است که Agile یعنی نداشتن برنامه. پروژه Agile هم برنامهریزی میخواهد، فقط جزئیات آن از ابتدا به اندازه Waterfall نیست. Milestoneها، یا همان epicها در ادبیات Agile، شناسایی و به taskهای آماده اجرا تبدیل میشوند. سپس این taskها در دورههای کوتاهی به نام sprint قرار میگیرند که معمولاً یک یا دو هفتهاند. در پایان هر sprint، نتیجه و نحوه انجام کار مرور میشود. معمولاً هدف این است که بخشی از functionality تحویل داده شود تا دیگران، در صورت امکان، با نتیجه واقعی تعامل کنند.
Agile ممکن است بسیار فرایندمحور به نظر برسد و در ابتدا ترسناک باشد، اما بیشتر مجموعهای از راهنماهاست تا قوانین تغییرناپذیر؛ frameworkی برای ایجاد نظم و جریان در کاری که میتواند مبهم باشد. بعضی سازمانها چنان درگیر قواعد میشوند که لذت و انعطاف پروژه را از بین میبرند. پیدا کردن تعادل مناسب تیم، فلسفه Agile را موفق میکند. Scrum یکی از نمونههای روشهای Agile است.
پروژه Agile تغییر را آسانتر میپذیرد، چون فرصتهای زیادی دارید تا پیش از اتلاف زمان، بفهمید چیزی جواب میدهد یا نه. انعطاف کلید موفقیت است. از بخشهایی شروع کنید که با شیوه فعلی کار تیم سازگارند و بهتدریج انضباط بیشتری اضافه کنید تا تیم در طول مسیر مزایا و موفقیتها را ببیند. برای مطالعه بیشتر، به Waterfall vs. Agile مراجعه کنید.
۹.۲ استانداردهای توسعه (Development standards)
وسوسهانگیز است که بگذارید تیمهای development بدون standard یا guideline مشخص کار خودشان را بکنند، اما این آزادی بیقاعده با رشد سازمان دردسر میسازد. آخرین چیزی که میخواهید، بخشهای بزرگی از code حیاتی است که شکننده و پیچیدهاند و فقط چند نفر از ترس پیامدها جرئت تغییرشان را دارند. هر شرکت «بخشهای مقدس code» خودش را دارد؛ قسمتهایی که طی سالها درباره پیچیدگیشان افسانه ساخته شده است. کافی است کسی پیشنهاد rewrite بدهد تا افراد قدیمی تیم با آه و تکاندادن سر، او را حتی از تغییر کوچک هم منصرف کنند.
همانطور که بارها در این کتاب گفتهایم، وظیفه رهبر فناوری فقط حل مسئلههای امروز نیست؛ باید پایه آینده را هم بسازد. سیستمهایی که اکنون توسعه پیدا میکنند، سالها به support و گسترش نیاز خواهند داشت؛ معمولاً بسیار بیشتر از مدت حضور شما در سازمان.
Standardها زبان مشترکی درباره ساختار، چیدمان و شیوه نوشتن code میسازند. نوشتن code با توجه به scalability و readability تلاش میخواهد. بعضی developerها فکر میکنند code آنها دستنزدنی است و review لازم ندارد. این افراد را زود شناسایی کنید؛ اگر نتوانستید این نگرش را تغییر دهید، همکاری را ادامه ندهید.
Coding بیشتر هنر است تا علم و جای زیادی برای برداشتهای متفاوت دارد. چیزی که برای یک developer طبیعی است، ممکن است برای دیگری ناآشنا و نامأنوس باشد. Developerها گاهی عادت دارند هرچه را نمیفهمند rewrite کنند؛ همان افتادن از چاله به چاه. پس به نفع همه است که code با روشها و patternهای مشترک نوشته شود تا خواندن و فهمیدنش آسان باشد.
خوشبختانه این مسئله تازهای نیست. زبانهای اصلی، coding standardهای مختلفی دارند و لازم نیست چرخ را از نو اختراع کنید. ابزارهای third-party که به بیشتر IDEها متصل میشوند، اجرای قواعد پایه را آسان میکنند. میتوانید ابزارهایی هم به build cycle اضافه کنید تا code را پیش از deploy بررسی کنند. برای مثال، SonarQube ابزاری open source است که زبانهای رایج را پوشش میدهد و مواردی مثل dangling variable declaration، null pointer trap و logic cul-de-sac را شناسایی میکند.
Coding standard فقط formatting یک text file نیست. میتواند design patternهای مشترک را تعیین کند؛ مثلاً نحوه تعامل با database یا ثبت log. همچنین باید ساختار code، تراکم functionها، class hierarchy و حتی naming conventionها را روشن کند.
این قواعد میتوانند بهتدریج شکل بگیرند و به استاندارد تیم تبدیل شوند. Code review باید منظم باشد و هیچکس نباید code خود را فراتر از نقد بداند؛ حتی شما، اگر در نقش CTO هنوز code مینویسید. Code باید خوانا، قابل نگهداری و تا حد ممکن بدون خطا باشد. Standardها و code review به تحقق این هدف کمک میکنند.
۹.۳ کنترل نسخه (Version control)
Version control (VC) هم کتابخانه داراییهای دیجیتال شماست و هم حافظه تاریخ آنها. زمانی فقط تیمهای بزرگ development از آن استفاده میکردند، اما امروز در DNA کار coding جا گرفته و به بخشهای دیگر کسبوکار هم راه یافته است؛ نمونهاش Google Docs که تاریخچه تغییرات documentها را نگه میدارد.
VC از CVS به SVN و سپس Git تکامل یافته است؛ Git رایجترین گزینه است و GitHub یکی از بزرگترین repositoryهای open source software به شمار میرود. اصل ثابت مانده است: ممکنکردن parallel development برای یک یا چند developer، بدون اینکه برای نگهداری نسخههای مختلف مجبور شوند development environment خود را به شکلهای عجیب تغییر دهند.
فرض کنید وسط توسعه یک نسخه بزرگ تازه هستید و باید bugی را در production فعلی اصلاح کنید. به source code همان نسخهای نیاز دارید که در production اجرا میشود، بدون featureهای تازه؛ تا bug را با اطمینان رفع و code را release کنید و نگران واردشدن کارهای ناتمام به production نباشید.
بعضی تیمها هنوز هیچ version controlی ندارند و نسخههای releaseشده را در directoryهای جدا یا گاهی در یک zip file نگه میدارند. بهانههایی مثل «نیازی نداریم»، «زبان ما برای check-in و check-out مناسب نیست» یا «سرعت ما را کم میکند» پذیرفتنی نیستند. ریشه مسئله، ترس از ناشناختههاست.
از دل تجربه: بهای نداشتن کنترل نسخه (From the field: Price of not having version control)
اوایل کارم، در پروژهای برای سازمان ملل در رم، Java Servlet مینوشتم تا عکسهای ماهوارهای زمینهای کشاورزی
آفریقا را پردازش کنیم. آنها Perl CGI scriptهایی داشتند که دسترسی دانشگاهیان به عکسها را از طریق browser
Mozilla فراهم میکرد. از ما دعوت شده بود Java Servlet جدید را زیر بار واقعی امتحان کنیم.
چند ماه آنجا بودم. یک هفته سخت کار میکردم تا بخش تازهای را پیش از پرواز و چند روز بازگشت به خانه تمام
کنم. خبری از coding standard و فرایند مشخص نبود، چه برسد به version control؛ وضعیتی که بیش از ۲۵ سال پیش
غیرعادی نبود. خودم روی یک network directory جداگانه backup میگرفتم و فکر میکردم کار هوشمندانهای کردهام.
حین یک test، بخشی از فرایند temporary fileها را حذف میکرد؛ آن روزها disk space ارزش زیادی داشت. در عجله
اشتباه کردم و تمام source fileها، هم نسخه local و هم backup روی network drive، حذف شدند. هرچه تلاش کردم
نتوانستم آنها را restore کنم. کار یک هفته از بین رفته بود. چارهای نداشتم جز اینکه آخر هفته بمانم و همه را
دوباره بنویسم. آن هفته درسهای زیادی گرفتم و از آن زمان دیگر چنین اتفاقی برایم تکرار نشده است.
در بالاترین سطح، version control به مجموعهای از repositoryها تقسیم میشود. میتوانید آنها را شبیه folder تصور کنید، اما این تشبیه همه ظرفیتشان را نشان نمیدهد. Repository بیشتر شبیه یک component یا بلوک سازنده سازمان است؛ کپسول زمانی زندهای که تلاشها، تاریخچه و تکامل یک بخش از کار را کنار هم نگه میدارد.
انتخاب granularity مناسب repository بیشتر هنر است تا علم و پاسخ واحدی برای همه ندارد. این پرسشها کمک میکنند:
- آیا این بخش function یا نقش مشخصی دارد؟
- آیا maintenance آن به مجموعه مهارت متفاوت یا تخصصیتری نیاز دارد؟
- چه ارتباطی با componentهای دیگر دارد؟
- این component یا پروژه چگونه release میشود؟
تعداد repositoryها نباید آنقدر زیاد باشد که overhead مدیریتشان سنگین شود یا آنقدر کم باشد که جداکردن و مدیریت commitها دشوار شود؛ از جمله یک repository واحد که همهچیز را در خود جا میدهد. باید نقطه تعادل مناسب سازمان را پیدا کنید.
همانطور که file و folder تعیین نمیکنند چه محتوایی در آنها قرار گیرد یا چقدر تودرتو باشند، version control هم بهتنهایی strategy شما را مشخص نمیکند؛ فقط ابزارها و قواعد کار را فراهم میکند. خوشبختانه patternهای شناختهشدهای وجود دارند که میتوانید از میانشان انتخاب کنید. دو نمونهای که کتاب معرفی میکند:
- Gitflow: دو branch اصلی
masterوdevelopداریم. همه codeهای master باید قابل deploy باشند. برای development، یک feature branch از develop میسازید که پس از review دوباره به develop، merge میشود. برای release، تغییرات develop را به master، merge میکنید. هیچ codeی مستقیم به master یا develop، commit نمیشود. - GitHub flow: مدل سادهتری است که فقط یک branch اصلی، در مثال کتاب
master، دارد. کار در feature branch انجام میشود و پس از review و testing به master، merge میشود و آماده deploy است.
در هر pattern میتوانید integration با ticket system، naming convention مربوط به feature branchها، اندازه یا عمر branch و release cycle را تعریف کنید. این انتخابها باید با محیط شما سازگار باشند تا بتوانید tooling و گزارشهای لازم را بسازید و از version control بیشترین استفاده را ببرید.
۹.۴ تضمین کیفیت (Quality assurance — QA)
Quality assurance (QA) یا testing، خودش یک تخصص مستقل است. هدف آن ساده است: آیا چیزی که ساخته یا نصب کردهاید، همان کاری را انجام میدهد که انتظار دارید؟
Testing آسان نیست؛ احتمالاً یکی از سختترین کارهای گروه شماست. پیشبینی تمام حالتها و actionهایی که یک software میتواند تجربه کند تقریباً ناممکن است. Test مثل پول است: هرقدر داشته باشید، باز هم کمی بیشتر به کارتان میآید.
یک چیز را درباره خودمان میدانیم: ما engineerها معمولاً testerهای خوبی نیستیم، بهویژه برای کار خودمان. بنابراین بهتر است فرد یا ابزار دیگری code را مستقل test کند. داشتن تیم QA جداگانه درون engineering، با فاصله از source code، کمک میکند fixها و featureها از نگاه end user بررسی شوند. دو نوع testing که ممکن است مدیریت کنید عبارتاند از:
- Manual testing
- Automated tests
۹.۴.۱ آزمون دستی (Manual testing)
در manual testing، انسان یک یا چند test را اجرا میکند تا تحقق success criteria را تأیید کند. معمولاً وقتی automated test برای سناریویی بیش از حد دشوار یا شکننده است، از این روش استفاده میشود.
رایج است که تیم QA محصول را بسیار خوب بشناسد و مجموعهای از test planها داشته باشد که دستکم بخشهای پرکاربرد را پوشش دهند. بهتر است test plan و روش اجرا طوری نوشته شوند که هرکسی بتواند testها را انجام دهد؛ نباید فقط یک نفر بداند code را چگونه باید درست test کرد.
Testing میتواند بسیار زمانبر باشد و testing fatigue ایجاد کند. مثلاً وقتی بخشی همیشه pass میشود، tester ممکن است کمکم آن را رد کند و فرض بگیرد باز هم درست کار میکند. این وضعیت خطرناک است، چون تشخیصدادنش آسان نیست.
خوب است developerهای تازه پیش از شروع کار روی code، مدتی در تیم QA بچرخند. هم محصول را میشناسند و هم با سطح testing گروه آشنا میشوند؛ در نتیجه میدانند نمیتوان هر چیزی را بدون بررسی از این مرحله عبور داد.
از دل تجربه: آزمودن آزمونگرها (From the field: Testing the testers)
چند CTO را میشناسم که هنگام حضور افراد تازهوارد در QA، عمداً بخشهای معیوب به آنها میدهند تا ببینند آیا متوجه مشکل میشوند. ممکن است functionality آشکارا خراب باشد یا بخشی از فرایند یا look and feel با standard مطابقت نداشته باشد. شاید در نگاه اول کمی زیرکانه به نظر برسد، اما توجه به جزئیات و اعتماد به فرایند و فرد تازهوارد را تقویت میکند.
۹.۴.۲ آزمونهای خودکار (Automated tests)
آرزوی هر CTO، engineer یا product owner این است که همه code با automated test پوشش داده شود. Automated test به دخالت مستقیم انسان نیاز ندارد و میتواند بخشی از build-and-release pipeline باشد. Unit test، API endpoint testing و end user testing همگی میتوانند در این دسته قرار بگیرند؛ هر چیزی که codebase را بدون اجرای دستی توسط انسان بررسی کند.
ساختن و نگهداری automated test آسان نیست، چون برای اجرای درست یک توالی از business logic ممکن است به سناریوها و وضعیتهای مشخص data نیاز داشته باشید. مثلاً test حذف record یک شخص باید record را حذف کند و سپس حذفشدنش را تأیید کند. ساده به نظر میرسد، اما پیش از آن باید record را بسازید تا چیزی برای حذفکردن داشته باشید. به دنیای testing خوش آمدید!
از دل تجربه: فریب کمیت را نخورید (From the field: Don’t be seduced by quantity)
Glen Martin که زمانی Product Manager مربوط به Java Enterprise specification بود، درس مهمی درباره کیفیت در برابر کمیت testها به من داد. پرسید ترجیح میدهم خودرویی را برانم که ۱۰٬۰۰۰ test روی آن اجرا شده یا خودرویی با فقط یک test. من که engineer تازهکاری بودم، طبیعتاً گزینه ۱۰٬۰۰۰ test را انتخاب کردم. اما در دام برابر دانستن تعداد و کیفیت افتاده بودم. او توضیح داد در میان آن ۱۰٬۰۰۰ test، هیچکدام موتور را روشن نکرده بود؛ درحالیکه تنها test خودروی دوم، روشنکردن موتور بود. مثال ساده و روشنی بود، اما نزدیک به ۲۵ سال بعد هنوز آن را به یاد دارم.
Code coverage یکی از metricهای مهم در ارزیابی کیفیت testهاست: چه مقدار از code واقعاً هنگام اجرای test اجرا شده است؟ اهمیت همه codeها یکسان نیست. بعضی بخشها بیشتر اجرا میشوند یا service حیاتیتری ارائه میکنند. هنگام بررسی code coverage باید moduleهای حیاتی را شناسایی کنید و برای آنها coverage مناسبی داشته باشید. دستیابی به ۱۰۰٪ code coverage تقریباً ناممکن است و بازه ۵۰٪ تا ۷۰٪ در این بحث عملکرد بسیار خوبی به شمار میرود.
Automation کارهای تکراری manual testing را حذف میکند و احتمال testing fatigue و جاافتادن مرحلههای مهم را کاهش میدهد. اما ساختن automation framework تلاش و maintenance مداوم میخواهد. هر feature تازه ممکن است testی را بشکند که بعد باید update شود.
وقتی زمان پروژه کم میآید، توسعه testها معمولاً از اولین چیزهایی است که اولویتش پایین میرود. فرض کنید build بهدلیل fail شدن یک automated test متوقف شده است. خودتان را قانع میکنید که دلیلش business logic تازه است و نتیجه فقط یک false negative است. پس بهجای اصلاح test، آن را غیرفعال میکنید تا build تمام شود و به deadline برسید.
روزها و هفتهها میگذرند و test هرگز اصلاح یا دوباره فعال نمیشود. همه ما چنین موقعیتی را تجربه کردهایم؛ نمونه دیگری از ورود technical debt به سیستم. Automated testing انضباط زیادی میخواهد، اما ارزشش را دارد و یک test suite که خوب نگهداری شود، در آینده بارها به کارتان میآید.
۹.۵ یکپارچهسازی و استقرار پیوسته
(CI/CD — Continuous integration
/ Continuous deployment)
Build و deploy کردن software پیچیده است. تیمها بزرگتر و پراکندهتر میشوند، افراد بیشتری همزمان روی codebase کار میکنند و اعضا میآیند و میروند. با این پیچیدگی و جابهجایی افراد، چگونه مطمئن میشوید همه میتوانند دقیقاً همان خروجی را build کنند؟ پاسخ، code pipeline یا CI/CD (continuous integration / continuous deployment) است.
از دل تجربه: فقط فِرِد میتواند آن سرویس را بهروزرسانی کند
(From the field: Only Fred can update that service)
اگر compile، package و deploy کردن production code به یک machine یا یک نفر وابسته است، مشکل dependency
دارید. گرفتارشدن در این وضعیت آسان است؛ روشی که سالها کار کرده، معمولاً مشکل جدی یا اولویت اصلاح به نظر
نمیرسد. این را در شرکتهای portfolio که بنیانگذار آنها را اداره میکند زیاد میبینم.
در یک مورد، فرد مسئول اجازه داده بود machine ویندوزی به آخرین .NET libraryها update شود و build از کار
افتاد. شرکت دیگر نمیتوانست محصول اصلیاش را update کند و همه نگران شده بودند. برای حل کوتاهمدت مسئله،
آنها را به یک virtualized environment منتقل کردیم تا buildها دسترسپذیرتر و پیشبینیپذیرتر شوند.
بهعنوان CTO مسئول maintainability بلندمدت سازمان هستید؛ یعنی باید بتوان در هر زمان، بدون حضور یک فرد خاص، code را با اطمینان build، update و deploy کرد. متأسفانه توان release بسیاری از سازمانهای کوچک به این وابسته است که یک نفر مشخص در مرخصی باشد یا نباشد.
فلسفه CI/CD این است که بهمحض review، تأیید و merge شدن code در یک branch، فرایند compile و testing خودکار اجرا شود و سپس نتیجه به server environment مشخصی deploy شود. هر failure در هر مرحله باید فوراً برای رسیدگی مشخص شود.
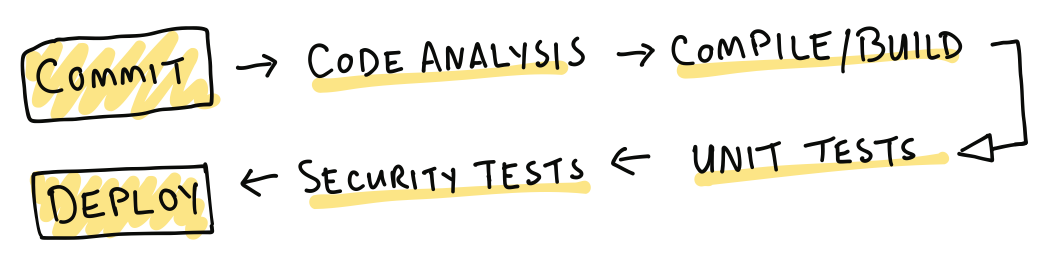
یک CI/CD pipeline معمولی با commit روی یک branch از repository آغاز میشود؛ در مثال کتاب، معمولاً branch
develop پس از merge شدن code یک pull request. سپس این مرحلهها یا gateها اجرا میشوند که برای
پذیرش و deploy شدن خروجی باید موفق باشند:
- Commit: رویداد آغاز pipeline؛ معمولاً commit یا merge موفق code در یک branch مشخص.
- Code analysis: بررسی source code آن branch با ابزارهایی مثل SonarQube و مجموعهای از کنترلهای کیفیت.
- Compile/build: در صورت نیاز، compile کردن code و ساختن یک deployable artifact.
- Unit tests: اجرای unit testها پس از build، برای بررسی اینکه bug تازهای وارد codebase نشده باشد.
- Security tests: اجرای testها و بررسیهایی که برای اطمینان از security طراحی شدهاند.
- Deploy: قرارگرفتن code در یک server environment، مثل development یا testing. بسته به branch، مقصد ممکن است production باشد.
میتوانید هر تعداد مرحله که برای محیط شما لازم است اضافه کنید. قدرت این automation pipeline در این است که هیچ مرحلهای جا نمیافتد و هر بخش یا library در محیطی مستقل از desktop یک developer قابل build است. به این ترتیب، بهانه معروف «روی machine من که کار میکند» دیگر تعیینکننده نیست.
راهاندازی چنین pipelineای مثل گذشته دشوار نیست. GitHub، Bitbucket و CodeCommit از جمله ابزارهایی هستند که به شکلی از CI/CD pipeline پشتیبانی میکنند. اگر orchestration پیچیدهتری برای چند repository و service لازم باشد، میتوانید از ابزاری مثل Jenkins استفاده کنید.
با تجربه بیشتر، checkهای بیشتری اضافه خواهید کرد. اگر تازه شروع کردهاید، از همان ابتدا سراغ پیچیدگی زیاد نروید. یک مسیر ساده Commit → Build → Deploy برای بسیاری از سازمانها مفید بوده است.
وقتی مرحلهای fail میشود، audit trail موجود در version control کمک میکند بفهمید مشکل با کدام تغییر و توسط چه کسی وارد شده است. هدف سرزنش نیست؛ هدف ساختن محیطی باز است که همه بتوانند کار یکدیگر را نقد کنند و برای software باکیفیتتر همکاری کنند.
CI/CD pipeline قوی امکان رشد سریع تیم را فراهم میکند، چون کنترلهایی دارید که مسیر کار را مشخص نگه دارند. خطاهای رایجی که میتوانند build را متوقف کنند عبارتاند از:
- Compilation error
- Missing library dependency
- نقض coding standard یا قواعد انطباق code
- Test failure
- Security scan failure، مثلاً باقیماندن password یا hardcoded key در code
- Database misalignment
هر test بیشتر، هرچند کوچک، به اعتماد تیم هنگام release اضافه میکند و ریسک را کاهش میدهد. این مجموعه checkها پشتوانه ذهنیت «Release small; release often» است. تعداد releaseها به شرایط شما بستگی دارد، اما چرا یک bug fix باید بیشتر از زمان لازم منتظر بماند، بهخصوص اگر زیرساخت zero-downtime release، مثلاً در یک serverless environment، دارید؟
بعضی تیمها چند بار در هفته، بعضی روزی یک بار و بعضی چند بار در روز release میکنند. من شرکت بزرگ Fortune 100ای را میشناسم که در کل زیرساختش روزانه هزاران release دارد. Pipeline درست ظرفیت بسیار بالایی ایجاد میکند، بهخصوص در Cloud که build environment میتواند on demand بالا بیاید.
۹.۶ بدهی فنی (Technical debt)
تصور کنید با خودرویی رانندگی میکنید اما هرگز روغن، فیلتر یا تایرهایش را عوض نمیکنید. در کوتاهمدت کمی پول ذخیره میکنید، اما با هربار عقبانداختن این کارها، مقداری «بدهی خودرو» ایجاد میشود. جایی این بدهی از ارزش خودرو بیشتر میشود؛ موتور از کار میافتد یا تایر در بزرگراه میترکد و هزینه بسیار بزرگتری تحمیل میکند. پس انجام بهموقع کارهای کوچک، از خرابیها و هزینههای بزرگ و غیرمنتظره ارزانتر است.
در سازمان هم همین اتفاق برای source code و سیستمها میافتد. هر میانبر، مثل hardcode کردن یک مقدار، انجام حداقل checkها روی یک function یا عقبانداختن security patch و upgrade، مقداری technical debt ایجاد میکند.
Technical debt در جریان کار یک سازمان پرشتاب بهطور طبیعی شکل میگیرد. برای پیشبردن کار پذیرفتنی است، به شرط اینکه مثل کارت اعتباری با آن برخورد کنید: میتوانید هزینه کوتاهمدت را روی کارت بگذارید، اما باید در پایان ماه آن را تسویه کنید.
چه مقدار زمان باید برای کمکردن technical debt بگذارید؟ به نوع سازمان بستگی دارد. قاعده تجربی من این است که ۱۰٪ تا ۳۰٪ خروجی تیم به کاهش این بدهی اختصاص پیدا کند.
ابزارهای code quality در pipeline، مانند SonarQube، به شناسایی و برآورد technical debt در source code کمک میکنند. هنگام code review، release و upgrade، مواردی را که میبینید مشخص و برای رسیدگی بعدی وارد backlog کنید. ممکن است code از نظر syntax کاملاً درست باشد و code analysis tool آن را علامت نزند، اما شما بدانید یک fix موقتی است که بعداً باید کاملتر شود.
CTO خوب میداند گروهش در هر لحظه چه میزان technical debt دارد. اگر با sprint کار میکنید، پس از هر دو یا سه sprint فرصتی برای رسیدگی به technical debt در نظر بگیرید.
۹.۷ انتشار (Release)
به قول معروف، تا چیزی تحویل ندهید کاری نکردهاید. Release کردن code یا update یک enterprise platform زنده میتواند اتفاقی ساده و بیدردسر باشد، اما برای رسیدن به این سادگی باید تلاش زیادی پشت صحنه انجام شود.
قبلاً update کردن software خودش پروژهای مستقل بود: تعیین downtime خارج از ساعت کاری، اطلاعدادن به مشتریان، آمادهکردن فهرست مراحل و اجرا با این امید که چیزی خراب نشود؛ چون کسی حتی نمیخواست به rollback فکر کند. در مقابل، در architectureهای جدید انتظار zero-downtime update داریم و ممکن است چند بار در روز آن را انجام دهیم.
در این بخش، ویژگیهای یک release strategy خوب و برنامهریزی و ارتباط لازم برای موفقیت را بررسی میکنیم. «Release small; release often» فقط شعار نیست؛ انضباطی است که میتوان به آن رسید.
۹.۷.۱ انتشار همراه با قطعی (Outage release)
نوع اول release به downtime واقعی نیاز دارد و سیستم باید offline شود. ممکن است componentها به restart نیاز داشته باشند یا data باید از نسخه قدیمی به جدید migration شود. این نوع release برنامهریزی بیشتری میخواهد، از جمله:
- مشخص کنید کدام serverها و componentها باید offline شوند.
- تجربه مشتری را تعیین کنید؛ مثلاً آیا باید maintenance page نمایش دهید؟
- بازه زمانی لازم را با احتساب همه این مرحلهها محاسبه کنید:
- زمان shutdown
- زمان update کردن software و hardware
- زمان راهاندازی دوباره
- زمان testing پیش از بازگشت کاربران
- زمان فعالکردن دوباره دسترسی کاربران
- برای هر بخش، مراحل دقیق لازم را بنویسید.
- برای هر مرحله مسئول مشخص و روش handoff به مرحله بعد تعیین کنید.
- با کسبوکار درباره تاریخهای ممکن release توافق کنید؛ ترجیحاً در کممصرفترین بازه.
- فهرست دریافتکنندگان گزارش پیشرفت و افرادی را که باید از پایان release باخبر شوند مشخص کنید.
این مجموعه، release plan شماست. برای خرابشدن احتمالی کارها هم زمان در نظر بگیرید. مثلاً اگر کسبوکار downtime آخر هفته را تحمل میکند و شما فکر میکنید فقط دو تا چهار ساعت لازم دارید، بازه آخر هفته را بگیرید. اگر زودتر تمام شد، چه بهتر؛ اگر مشکلی پیش آمد، بدون درخواست زمان بیشتر فرصت رسیدگی دارید.
با شروع release، هر مرحله را اجرا کنید و وضعیت را به افراد تعیینشده اطلاع دهید. از انتقال خبر بد فرار نکنید. اگر کار طولانیتر شده یا از برنامه خارج شدهاید، اطلاعرسانی بهتر از سکوتی است که دیگران را به این شک میاندازد که کسی مسئول کار نیست.
اگر این فرایند تکرار میشود، بهتر است فرصتی برای تمرین پیدا کنید. البته بسته به سیستم، همیشه ممکن نیست. مثلاً migration یک back-office system مثل email ممکن است آنقدر زمانبر باشد که اجرای تمرینی در مقیاس واقعی عملی نباشد.
پس از پایان release، یک postmortem برگزار کنید: موفقیتها را ببینید و از چیزهایی که بد پیش رفتند یا دفعه بعد میتوانند بهتر شوند یاد بگیرید.
۹.۷.۲ انتشار آبی–سبز (Blue-green release)
بهطور سنتی، update یعنی جایگزینکردن code روی server؛ در عمل، تغییر fileهای server filesystem. این کار ریسک دارد و rollback را سختتر میکند، چون وضعیت filesystem تغییر کرده است.
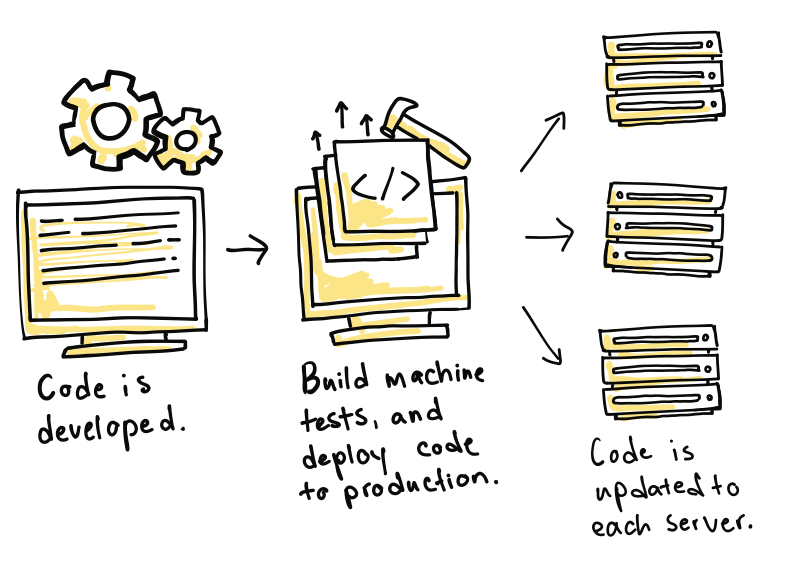
با virtualization و امکان بالا آوردن server در چند دقیقه یا چند ثانیه، فرصت بازنگری اساسی در روشهای کار به وجود آمد؛ از جمله release. بهجای update کردن serverهای فعلی، environment کاملاً تازهای میسازید که software جدید روی آن نصب شده، configuration آن آماده است و میتواند اجرا شود. با ابزاری مثل Docker میتوانید این آمادهسازی را script کنید و سریع انجام دهید. سپس environment تازه را test میکنید، درحالیکه architecture فعلی همچنان به traffic موجود پاسخ میدهد.
بعد از تأیید درستی کار، traffic را به environment تازه هدایت میکنید. وقتی همه traffic منتقل شد، محیط قدیمی را کنار میگذارید و محیط جدید تمام load را بر عهده میگیرد. اگر در بررسی اولیه مشکل دیدید، environment تازه را حذف میکنید و دوباره تلاش میکنید؛ traffic فعلی آسیبی ندیده است.
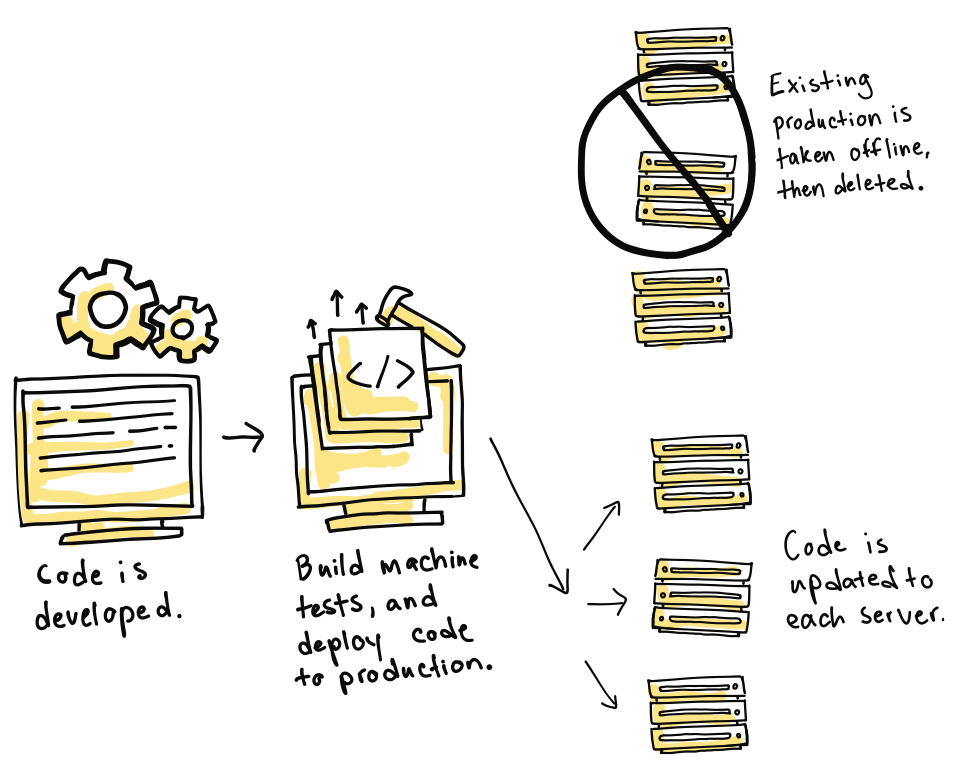
این روش blue-green release نام دارد. تسلط بر آن release cycle را کمتنشتر میکند و مزیت دیگری هم دارد: scriptهای ساخت infrastructure شما در هر بار اجرا امتحان میشوند. هرچه architecture پیچیدهتر باشد، اجرای درست این روش سختتر است، اما ناممکن نیست. این روش برای web applicationها بسیار مناسب است.
یکی از دشوارترین بخشهای هر release، تغییر database schema است. قاعده من برای حفظ امکان rollback این است: همیشه add کنید؛ فعلاً drop نکنید (always add, never drop). حذفکردن باعث میشود rollback بدون استفاده از backup ممکن نباشد. Table، column و index را میتوانید در releaseهای بعدی حذف کنید؛ وقتی از موفقیت release مطمئن شدهاید و دیگر نیازی به بازگشت به نسخه قبلی ندارید.
Releaseهایی که خوب تمرین شدهاند، فشار و ریسک update را کم میکنند و آن را به کاری عادی تبدیل میکنند. مستقل از release strategy، تهیه release notes عادت خوبی است: documentی از همه تغییرات که میتواند یک text file، صفحه wiki یا صفحه Atlassian Confluence باشد. بعضی ticketing systemها با tag کردن ticketها یا sprintهای مربوط به یک release، تولید release notes را خودکار میکنند.
این document بهخصوص زمانی مفید است که کسبوکار باید به مشتری توضیح دهد چه چیزی release شده است. میتوان فهرست خام تغییرات را به زبانی بازنویسی کرد که برای end user معنی روشنتری داشته باشد.
۹.۸ درخواستهای مشتری (Client requests)
در یک سازمان بزرگ و موفق، feature request از همهطرف میرسد. مشتریان بزرگ نفوذ بیشتری دارند و اگر خواستههای آنها را مدیریت نکنید، ممکن است به سختترین مسئله شما تبدیل شوند. کسبوکار طبیعتاً میخواهد بزرگترین مشتریان خود را راضی نگه دارد تا همکاری ادامه پیدا کند.
اما بدون کنترل، ممکن است تغییرهایی را تأیید کنید که فقط برای یک مشتری خاصاند، overhead غیرضروری ایجاد میکنند و در نهایت حرکت platform را کند میکنند. پاسخ هم نمیتواند همیشه «نه» باشد؛ مانعتراشی دائمی رابطه شما را با کسبوکار و مشتری بهتر نمیکند. در عوض، هر feature request را طوری بررسی کنید که انگار قرار است برای همه مشتریان ارائه شود:
- آیا دیگران هم از آن ارزش میگیرند؟ اگر بله، احتمالاً باید بههرحال در roadmap باشد.
- آیا با تعریف دقیقتر یا گفتوگوی بیشتر میتوان آن را برای گروه بزرگتری مفید کرد؟
- اگر برای بقیه کاربردی ندارد، آیا راه دیگری برای رسیدن به خواسته مشتری هست؟
فراهمکردن امکان export یا import کردن data به مشتری اجازه میدهد راهکاری بیرون از سیستم بسازد؛ شاید با API شما، اگر در دسترس باشد. برای سیستمهایی با customization زیاد، یک plugin pattern در نظر بگیرید تا گسترش سیستم بدون دستزدن به core ممکن شود. وضعیتی که نمیخواهید به آن برسید، همان مثال آشنای زیر است:
if (Client == XYZ) {
  // do something client specific
}
این از سریعترین راههای ایجاد technical debt است. Codebase پیچیده میشود، بخشهایی به وجود میآیند که testing آنها دشوار است و ممکن است هرگز فرصت تغییرشان را نداشته باشید، چون مشتری به وجودشان وابسته شده است.
از دل تجربه: مشتری همیشه حق دارد (From the field: The client is always right)
در شرکتهای portfolio با اندازهها و سنهای مختلف، نمونههای زیادی از الگوی «if client, then» دیدهام و
همه با پشیمانی همراه بودهاند: در آن مسیر گیر کردهاند و هر release پیچیدگی بیشتری ساخته است. حالت شدیدتر
این است که کل repository برای یک مشتری خاص branch شود. این وضعیت بسیار خطرناک است و شما را در مسیر شکست
قرار میدهد.
در عمل، فقط حجم کار را از همه جهت دو برابر کردهاید. هر feature تازه یا bug fix باید روی تمام branchهای
فعال اعمال و test شود. اگر شنیدید که میگویید «فقط برای همین یک مشتری یا feature است»، وقت آن است که دوباره
فکر کنید. خود آیندهتان از شما تشکر خواهد کرد.
جمعبندی (Summary)
- پیشبینی timeline پروژه بهدلیل رخدادهای بیرونی و ناشناخته دشوار است.
- شکستن پروژه به componentهای کوچکتر، مثلاً با Agile، پیشبینی timeline را آسانتر میکند.
- Ticket system منظم و درست مدیریتشده، دید عمیقی از وضعیت taskها به شما و تیم میدهد.
- با رشد تیم، project manager قوی در هدایت پروژهها در طول چرخه عمرشان بسیار ارزشمند است.
- Development standardهای ساده و پایه، code را خواناتر میکنند و maintenance آن را با رشد تیم آسانتر میسازند.
- Version control ابزار قدرتمندی برای مدیریت محیطی پویا و دائماً در حال تغییر است.
- Branching strategy مناسب، parallel development را بدون انتظار یا هماهنگیهای زمانی پیچیده ممکن میکند.
- شناخت technical debt، اولین قدم برای کاهش آن است.
- Testing میتواند manual یا automated باشد. سختی آن را بپذیرید، اما انجامدادن مقداری testing از نداشتن آن بهتر است.
- Release لازم نیست پیچیده و پرریسک باشد؛ برنامهریزی، تمرین و اطلاعرسانی، عوامل کلیدی آن هستند.
- Virtualization و Cloud، با امکان استفاده از blue-green strategy، ریسک release را کاهش میدهند.
- از feedback مشتریان و کاربران استقبال کنید، اما آن را طوری مدیریت کنید که codebase به مجموعهای چندپاره از تغییرات اختصاصی تبدیل نشود.
چکلیست نهایی (Checklist)
چند مورد از این موارد را واقعاً پوشش دادهاید؟
- اگر project manager نداریم، مسئولیت برنامهریزی و مدیریت کار دیگران روشن است.
- همه کارهای تیم از طریق یک ticket system پیگیری میشوند.
- برای تعریف و برنامهریزی پروژهها ریتم مشخصی داریم.
- Development standardها روشناند و تیم به آنها پایبند است.
- فرهنگ استفاده از version control جا افتاده و همه اهمیت و نقش آن را میدانند.
- Build و deployment process تکرارپذیر داریم که به یک فرد یا machine وابسته نیست.
- میزان technical debt را میشناسیم و برای کاهش آن برنامه داریم.
- Test environment اختصاصی داریم که مستقل از تیم development است.
- Release process در صورت نیاز امکان rollback دارد.
- ساختارهای اختصاصی از نوع
if-clientدر codebase نداریم.
خلاصه هوش مصنوعی (AI summary)
خلاصه فصل (Chapter summary)
این فصل درباره گذار از روش شخصی یک developer به development process قابل اتکای یک تیم است. CTO باید project planning و اطلاعرسانی واقعبینانه را با development standard، version control، QA و CI/CD همراه کند تا رشد تیم و تحویل محصول به حضور یک فرد خاص وابسته نماند.
- Taskهای کوچک، ticketهای بهروز و project manager مؤثر، وضعیت کار و ریسک timeline را روشن میکنند.
- Code review، testing مستقل و build و deployment تکرارپذیر، پایه release مطمئناند؛ تعداد test بهتنهایی معیار کیفیت نیست.
- Technical debt باید ثبت و برای کاهش آن ظرفیت تعیین شود. Release plan، rollback و blue-green release به مدیریت ریسک تغییر کمک میکنند.
- Feature request مشتری را با نگاه به کل محصول بررسی کنید و با API یا plugin pattern، از client lock-in و branchهای اختصاصی مشتری دور بمانید.
این خلاصه با کمک هوش مصنوعی بر اساس محتوای فصل تهیه شده و جایگزین مطالعه کامل متن نیست.